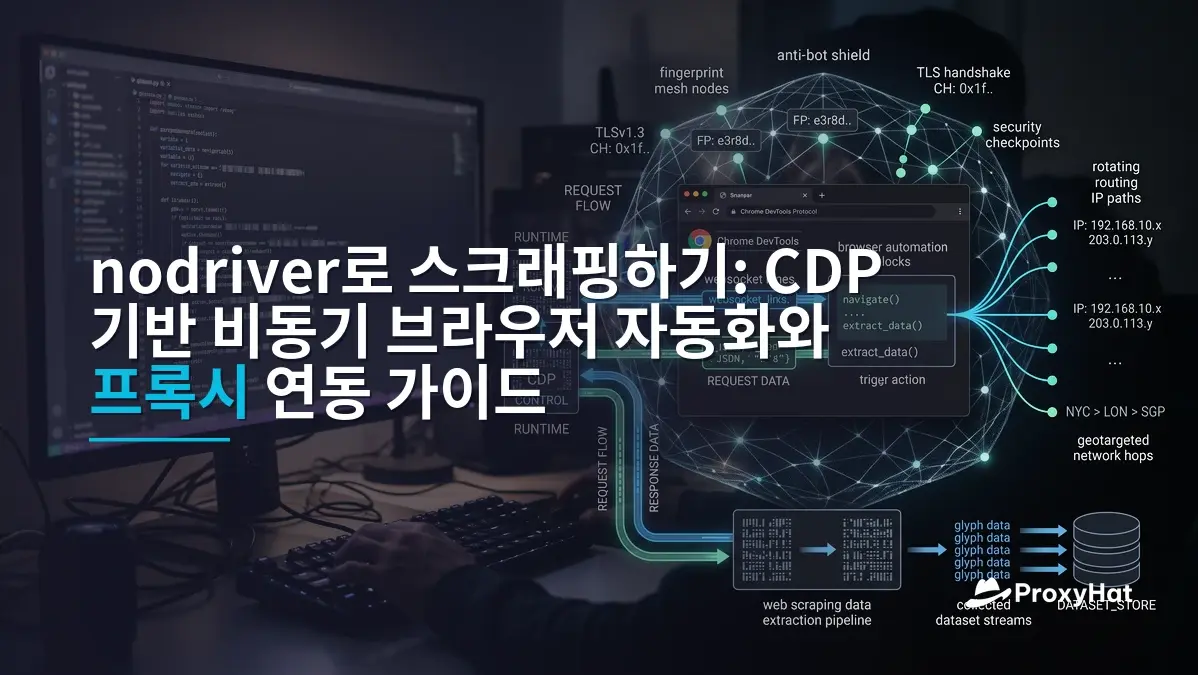
nodriver로 스크래핑하기는 더 이상 Selenium WebDriver에 의존하지 않고, Chrome DevTools Protocol(CDP)을 직접 WebSocket으로 통신하는 차세대 Python 브라우저 자동화 방식입니다. undetected-chromedriver(uc)의 작성자가 새로 만든 nodriver는 navigator.webdriver 플래그와 CDP 런타임 누수를 원천적으로 제거하여 Cloudflare, Imperva, DataDome 같은 봇 탐지 시스템을 우회하는 데 훨씬 유리합니다.
⚠️ 법적 고지: 이 글은 공개 데이터에 대한 승인된 자동화만을 다룹니다. 미국 CFAA(Computer Fraud and Abuse Act)와 EU GDPR은 무단 데이터 수집에 민사·형사적 책임을 부과할 수 있습니다. 대상 사이트의 robots.txt와 이용약관(ToS)을 반드시 확인하고, 인증이 필요한 페이지는 사전 허가를 받으십시오.
nodriver의 아키텍처: 왜 WebDriver를 버렸는가
기존 Selenium 기반 스크래핑은 ChromeDriver라는 중간 프로세스를 거칩니다. ChromeDriver는 WebDriver BiDi 프로토콜을 사용하여 브라우저를 제어하는데, 이 과정에서 브라우저에 navigator.webdriver = true라는 자바스크립트 플래그가 설정됩니다. Cloudflare의 Turnstile이나 Imperva의 봇 탐지 엔진은 이 플래그를 즉시 감지하여 요청을 차단합니다.
nodriver는 이 중간 계층을 완전히 제거합니다. Chrome DevTools Protocol을 통해 브라우저의 디버그 포트(기본 9222)에 직접 WebSocket 연결을 맺고, Runtime, Page, Network 도메인 명령을 전송합니다. ChromeDriver 프로세스가 없으므로 navigator.webdriver가 undefined로 남고, window.cdc_ 같은 ChromeDriver 주입 변수도 나타나지 않습니다.
이러한 설계 철학은 nodriver의 PyPI 패키지 설명에서도 명시적으로 강조됩니다: "Selenium/WebDriver를 사용하지 않으며, chromedriver 바이너리가 필요 없다"는 점이 핵심 차별점입니다.
CDP 직접 통신의 장점
- 제로 오버헤드: ChromeDriver 프로세스(약 30-50MB 메모리)가 없어 리소스 소비가 감소합니다.
- 스텔스: WebDriver 흔적(
navigator.webdriver,cdc_변수,--enable-automation플래그)이 자동으로 제거됩니다. - 비동기 네이티브: asyncio 기반이라 여러 탭을 동시에 제어할 때 스레드 오버헤드가 없습니다.
- 이벤트 기반:
tab.add_handler(CDP_EVENT_TYPE, callback)로 DOM 이벤트와 네트워크 이벤트를 리스닝합니다.
nodriver의 비동기 API: uc.start()부터 이벤트 훅까지
nodriver의 API는 undetected-chromedriver와 유사하지만 완전히 async/await 기반입니다. 핵심 객체는 Browser와 Tab이며, 모든 상호작용은 코루틴으로 이루어집니다.
기본 구조
import nodriver as uc
import asyncio

async def main():
    browser = await uc.start(
        headless=False,
        browser_args=["--disable-blink-features=AutomationControlled"],
    )
    tab = await browser.get("https://example.com")

    # 요소 선택 — WebDriver의 find_element 대신
    element = await tab.select("#content", timeout=10)
    if element:
        text = await element.get_text()
        print(text)

    await browser.stop()

asyncio.run(main())
uc.start()는 Chrome을 시작하고 첫 번째 탭을 반환합니다. browser.get(url)은 새 탭을 열고 Tab 객체를 반환합니다. tab.select()는 CSS 셀렉터로 요소를 찾으며, tab.find()는 더 유연한 검색(텍스트, 속성 등)을 지원합니다.
WebDriver waits 대신 이벤트 훅
Selenium에서는 WebDriverWait(driver, 10).until(EC.presence_of_element_located(...))를 썼지만, nodriver에서는 이벤트 핸들러나 tab.wait_for()를 사용합니다.
async def on_request(event):
    req = event.body
    if req.get("method") == "GET" and "/api/data" in req.get("url", ""):
        print(f"인터셉트: {req['url']}")

tab.add_handler(uc.cdp.network.RequestWillBeSent, on_request)
await tab.get("https://target-site.com")
await asyncio.sleep(5)  # 이벤트 수신 대기
이 방식은 폴링 기반 대기보다 효율적이며, 네트워크 응답을 가로채서 JSON API 응답을 직접 추출하는 데도 사용할 수 있습니다.
nodriver에 프록시 연동하기: browser_args와 ProxyHat
nodriver에는 내장된 프록시 회전 기능이 없습니다. 대신 Chrome의 --proxy-server= 커맨드라인 인수를 browser_args에 전달하여 프록시를 설정합니다. 하지만 Chrome의 --proxy-server는 인증을 지원하지 않습니다 — 사용자명/비밀번호가 필요한 프록시는 별도의 인증 헤더 주입이나 확장 프로그램이 필요합니다.
ProxyHat의 residential 프록시는 게이트웨이 기반 인증을 사용하므로, --proxy-server와 함께 인증 정보를 URL에 포함할 수 없습니다. 대신 Chrome 확장 기반 프록시 인증 또는 Page.authenticate CDP 명령을 사용합니다. nodriver에서는 CDP의 Fetch.authRequired 이벤트를 처리하는 것이 가장 깔끔한 방법입니다.
ProxyHat residential 프록시 URL 구성
def build_proxyhat_url(country="US", session="abc123"):
    """ProxyHat residential HTTP 프록시 URL 생성"""
    username = f"user-country-{country}-sid-{session}"
    password = "YOUR_PASSWORD"
    return f"http://{username}:{password}@gate.proxyhat.com:8080"

# SOCKS5를 사용하는 경우:
# socks5://user-country-US-sid-abc123:pass@gate.proxyhat.com:1080
ProxyHat 게이트웨이는 gate.proxyhat.com:8080(HTTP) 또는 gate.proxyhat.com:1080(SOCKS5)에서 수신합니다. 사용자명에 country-{국가코드}와 sid-{세션ID} 플래그를 포함하면 지정된 국가의 residential IP가 할당되며, 동일한 세션 ID를 사용하면 sticky session이 유지됩니다. 자세한 위치 옵션은 ProxyHat 위치 페이지를 참조하세요.
왜 residential IP가 필수인가
datacenter IP 대역(예: AWS, DigitalOcean, Hetzner)은 Cloudflare와 Imperva의 IP 평판 데이터베이스에서 거의 항상 플래그됩니다. nodriver로 브라우저를 완벽하게 스텔스 모드로 실행해도, 요청이 datacenter IP에서 오면 차단됩니다. residential IP는 실제 ISP에서 할당된 주소이므로 봇 탐지 엔진이 정상 사용자 트래픽과 구별하기 어렵습니다.
실행 가능한 예제: 보호된 페이지에서 JSON 추출
다음은 nodriver를 ProxyHat residential 프록시와 함께 사용하여 Cloudflare로 보호된 페이지에서 API 응답 JSON을 가로채는 완전한 예제입니다.
import nodriver as uc
import asyncio
import json

def build_proxyhat_url(country="US", session="abc123"):
    username = f"user-country-{country}-sid-{session}"
    password = "YOUR_PASSWORD"
    # Chrome --proxy-server에는 인증 URL을 직접 넣을 수 없으므로
    # 호스트:포트만 전달하고, CDP Fetch.authRequired로 인증
    return "gate.proxyhat.com:8080"

async def main():
    proxy_host = build_proxyhat_url(country="US", session="abc123")
    proxy_user = "user-country-US-sid-abc123"
    proxy_pass = "YOUR_PASSWORD"

    browser = await uc.start(
        headless=False,
        browser_args=[
            f"--proxy-server=http://{proxy_host}",
            "--disable-blink-features=AutomationControlled",
            "--no-first-run",
            "--no-default-browser-check",
        ],
    )

    # 프록시 인증을 위한 Fetch 도메인 활성화
    tab = await browser.get("about:blank")
    await tab.send(uc.cdp.fetch.enable(
        handle_auth_requests=True,
        patterns=[{"urlPattern": "*"}],
    ))

    captured_data = []

    async def on_auth_required(event):
        await tab.send(uc.cdp.fetch.continue_with_auth(
            request_id=event.request_id,
            auth_challenge_response=uc.cdp.fetch.AuthChallengeResponse(
                response="ProvideCredentials",
                username=proxy_user,
                password=proxy_pass,
            ),
        ))

    async def on_response(event):
        url = event.response.url
        if "/api/products" in url and event.response.status == 200:
            body = await tab.send(uc.cdp.network.get_response_body(
                request_id=event.request_id
            ))
            captured_data.append(json.loads(body[0]))

    tab.add_handler(uc.cdp.fetch.AuthRequired, on_auth_required)
    tab.add_handler(uc.cdp.network.ResponseReceived, on_response)

    await tab.get("https://protected-site.com/catalog")
    await asyncio.sleep(8)

    print(f"캡처된 API 응답: {len(captured_data)}개")
    for item in captured_data:
        print(json.dumps(item, indent=2)[:500])

    await browser.stop()

asyncio.run(main())
이 예제에서 핵심은 Fetch.authRequired 이벤트 핸들러로 프록시 인증을 처리하는 것입니다. Chrome의 --proxy-server는 인증을 자체 처리하지 않으므로, CDP Fetch 도메인을 활성화하고 continue_with_auth로 사용자명과 비밀번호를 전달합니다.
스케일링: 동시 탭, Docker 헤드리스 플릿, 컨텍스트별 프록시
동시 탭 관리
nodriver는 asyncio 기반이므로 단일 브라우저 프로세스에서 여러 탭을 동시에 제어할 수 있습니다. 하지만 모든 탭이 동일한 --proxy-server를 공유합니다. 서로 다른 IP가 필요하면 브라우저 인스턴스를 여러 개 실행해야 합니다.
async def scrape_with_proxy(country, session, url):
    proxy_host = "gate.proxyhat.com:8080"
    proxy_user = f"user-country-{country}-sid-{session}"
    proxy_pass = "YOUR_PASSWORD"

    browser = await uc.start(
        headless=True,
        browser_args=[
            f"--proxy-server=http://{proxy_host}",
            "--disable-gpu",
            "--no-sandbox",
            "--disable-dev-shm-usage",
        ],
    )
    tab = await browser.get(url)
    # ... 스크래핑 로직 ...
    await browser.stop()

async def run_fleet():
    tasks = [
        scrape_with_proxy("US", "s1", "https://example.com/page1"),
        scrape_with_proxy("DE", "s2", "https://example.com/page2"),
        scrape_with_proxy("JP", "s3", "https://example.com/page3"),
    ]
    results = await asyncio.gather(*tasks, return_exceptions=True)
    return results

asyncio.run(run_fleet())
Docker에서 헤드리스 플릿 운영
컨테이너 환경에서 nodriver를 실행할 때 주의할 점은 Chrome이 /dev/shm을 기본적으로 사용한다는 것입니다. Docker 컨테이너의 기본 /dev/shm 크기는 64MB로, Chrome이 메모리 부족으로 크래시할 수 있습니다. --disable-dev-shm-usage 플래그를 추가하거나 shm_size: 2g를 Docker Compose에 설정하세요.
# docker-compose.yml
version: "3.8"
services:
  scraper:
    build: .
    shm_size: "2gb"
    environment:
      - PROXYHAT_USER=YOUR_USERNAME
      - PROXYHAT_PASS=YOUR_PASSWORD
      - MAX_CONCURRENT=10
    deploy:
      replicas: 3
    restart: unless-stopped
컨텍스트별 프록시 할당
Chrome의 Browser Context(CDP Target.createBrowserContext)를 사용하면 동일한 브라우저 내에서 격리된 쿠키/세션 컨텍스트를 만들 수 있습니다. 하지만 --proxy-server는 브라우저 수준에서 설정되므로 컨텍스트별로 다른 프록시를 지정하려면 별도 브라우저 인스턴스가 필요합니다. ProxyHat의 sticky session(sid-{ID})을 사용하면 동일한 IP를 유지하면서 쿠키를 분리할 수 있습니다.
Graceful shutdown
스크래핑 작업이 중단될 때 브라우저 프로세스가 좀비로 남지 않도록 finally 블록에서 browser.stop()을 호출해야 합니다. SIGTERM 시그널 핸들러를 등록하면 Docker가 컨테이너를 종료할 때 정상적으로 브라우저를 닫을 수 있습니다.
import signal

async def main():
    browser = await uc.start(headless=True, browser_args=[...])
    # ... 작업 ...

async def graceful_shutdown(browser):
    await browser.stop()
    print("브라우저 정상 종료")

# signal 핸들러 등록
loop = asyncio.get_event_loop()
loop.add_signal_handler(signal.SIGTERM, lambda: asyncio.create_task(graceful_shutdown(browser)))
nodriver vs HTTP 스크래핑: 언제 전체 브라우저가 필요한가
nodriver는 강력하지만 모든 상황에 적합하지 않습니다. 대상 페이지가 서버 사이드 렌더링이고 API 엔드포인트가 발견 가능하다면, curl이나 curl_cffi(TLS 지문 모방 라이브러리)와 HTTP 프록시를 사용하는 것이 훨씬 저렴하고 빠릅니다.
| 기준 | nodriver + 브라우저 | curl_cffi + HTTP 프록시 |
|---|---|---|
| 메모리 사용량 | 200-500MB per Chrome 인스턴스 | ~20MB per 요청 |
| 요청 속도 | 2-5초 (페이지 로드 + 렌더링) | 200-800ms |
| JavaScript 실행 | ✅ 완전 지원 | ❌ 불가능 |
| Cloudflare Turnstile 통과 | 높은 성공률 (residential IP 필요) | 제한적 (TLS 지문만 모방) |
| 동시성 | 10-50 인스턴스 (서버 사양에 따라) | 500+ 동시 요청 가능 |
| 비용 (ProxyHat 기준) | 트래픽 기반, 브라우저는 더 많은 데이터 소비 | 동일 트래픽 기반이지만 소비량 적음 |
결론: 페이지가 JavaScript 챌린지(Cloudflare JS 챌린지, Imperva 봇 퍼즐)를 요구하거나 동적 렌더링이 필요하면 nodriver를 사용하고, 정적 HTML이나 API JSON만 필요하면 curl_cffi + ProxyHat HTTP 프록시를 사용하세요.
ProxyHat 설정 및 내부 링크
ProxyHat은 residential, mobile, datacenter 프록시를 제공합니다. nodriver와 함께 사용할 때는 residential 프록시를 권장합니다 — datacenter IP는 봇 탐지 시스템에서 차단될 확률이 높고, mobile IP는 신뢰도는 가장 높지만 비용이 더 듭니다. 가격 정보는 ProxyHat 가격 페이지에서 확인할 수 있으며, 웹 스크래핑 사용 사례는 웹 스크래핑 페이지를, SERP 추적은 SERP 추적 페이지를 참조하세요.
ProxyHat API 문서는 docs.proxyhat.com에서 확인할 수 있으며, 인증 토큰 발급, 세션 관리, 국가별 IP 할당 등의 상세 가이드가 제공됩니다.