


Cómo scrapear datos públicos de Reddit con proxies
Guía práctica para extraer datos públicos de Reddit usando proxies residenciales: desde la evolución de la API hasta ejemplos en Python y Node.js, manejo de rate limits y mejores prácticas éticas.


Página 8 de 13
Guía práctica para extraer datos públicos de Reddit usando proxies residenciales: desde la evolución de la API hasta ejemplos en Python y Node.js, manejo de rate limits y mejores prácticas éticas.
Análisis técnico profundo de la pila de detección de DataDome: huellas TLS JA3/JA4, fingerprinting de navegador, señales de comportamiento y por qué los proxies residenciales son esenciales para automatización legítima.
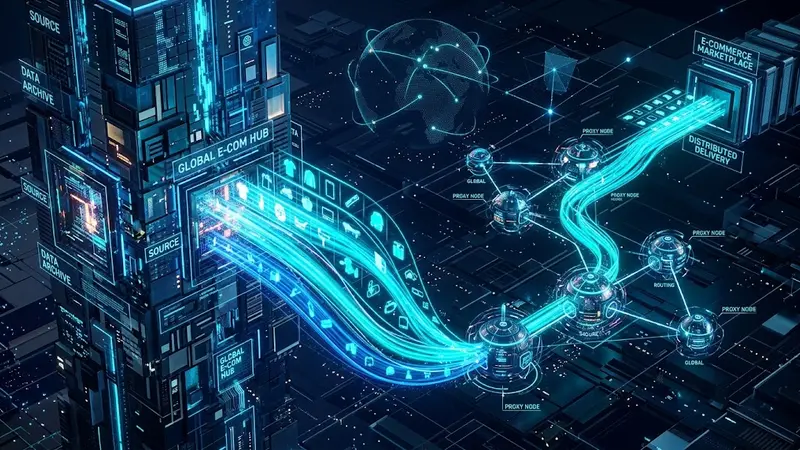
Aprende a scrapear eBay de forma fiable: cuándo usar las APIs oficiales vs. scraping HTML, selectores concretos, rotación de IPs residenciales con ProxyHat y código Python listo para ejecutar.
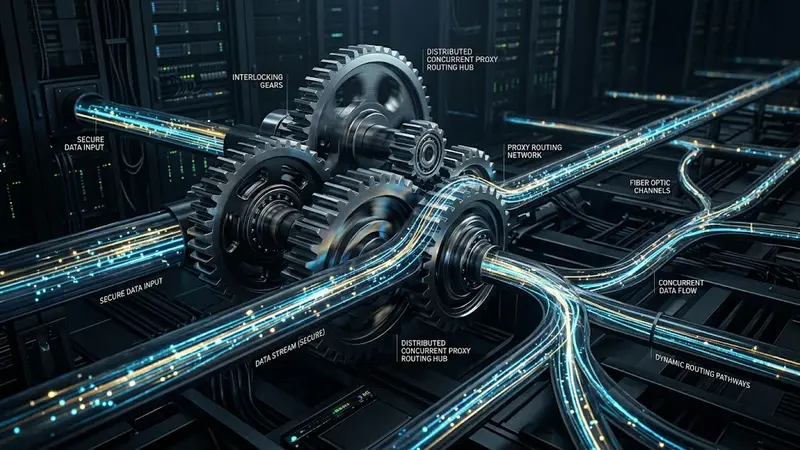
Aprende a configurar proxies HTTP en Rust con reqwest, hyper y tokio. Incluye rotación de IPs, TLS, concurrencia y manejo de errores para scraping de alto rendimiento.
Aprende a acceder legalmente a perfiles públicos, páginas de empresa y ofertas de trabajo de LinkedIn usando proxies residenciales. Incluye ejemplos en Python y Playwright, y análisis del caso hiQ Labs v. LinkedIn.
Aprende a configurar HTTP proxies en .NET 8 con HttpClient, SocketsHttpHandler, Polly para reintentos, pools de proxies rotativos con DI, y configuración TLS avanzada. Incluye ejemplos de código listos para producción.
Aprende a extraer datos públicos de YouTube con proxies residenciales: cuándo la API v3 basta, cómo funciona InnerTube, ejemplos en Python y Node.js, y buenas prácticas éticas.
Aprende a extraer datos públicos de TikTok sorteando su sistema anti-bot. Cubrimos proxies residenciales móviles, manejo del header _signature, ejemplos en Python con Playwright y estrategias de escalado para análisis de creadores.
Aprende a configurar y usar proxies HTTP en PHP con ejemplos prácticos de cURL, Guzzle, Symfony HTTP Client y Laravel. Incluye rotación de IPs, concurrencia y configuración TLS para scraping e integraciones robustas.
Aprende a construir una infraestructura de monitoreo de precios de viajes resistente a bloqueos: desde la elección de fuentes de datos hasta el cálculo de ROI y la decisión entre APIs comerciales vs scraping propio.
Guía práctica para extraer datos públicos de Twitter/X usando proxies residenciales. Cubre el panorama post-API, implementación en Python con Playwright, manejo de rate limits y consideraciones legales.
Aprende a configurar y usar proxies HTTP en Java 17+ con ejemplos prácticos de HttpClient, OkHttp, Jsoup y Apache HttpClient. Incluye estrategias de rotación de IPs, paralelismo y configuración TLS.